
Qu'est-ce qu'un test A/B (A/B testing) ? Guide du débutant : les 6 étapes, la significativité statistique et la taille d'échantillon
- ab-testing
- cro
- how-to
- beginners
Résumé de l'article
- Le test A/B (A/B testing) est une méthode qui consiste à répartir les visiteurs de façon aléatoire, à leur montrer la page d'origine (A) et une page modifiée (B) pendant la même période, puis à comparer chiffres à l'appui laquelle est la plus performante
- Une simple comparaison avant/après ne permet pas de séparer l'effet de votre modification de celui des saisons, de la publicité, des jours de la semaine, etc. Faire tourner les deux versions en même temps est le cœur du test A/B
- Le processus comporte 6 étapes : objectif et indicateur → hypothèse → création de la variante → lancement → analyse → application. Fixez la taille d'échantillon (la quantité de données) et la durée nécessaires avant de commencer
- La « significativité statistique » est un repère pour savoir si un écart s'explique difficilement par les seules variations aléatoires. Une p-value n'est pas « la probabilité que B soit gagnante »
- La plupart des échecs viennent du fait de « vérifier sans cesse les résultats et d'arrêter trop tôt », de « changer trop de choses à la fois » et de « laisser tourner le test trop peu de temps »
- Sur un site à faible trafic, vous pouvez quand même obtenir plus d'informations en changeant d'approche, par exemple en misant sur des changements plus importants ou en observant un indicateur situé plus tôt dans le parcours
« Et si on changeait le titre, peut-être que davantage de gens s'inscriraient ? » « Le bouton ne devrait-il pas être plus haut dans la page ? » Quand on gère un site web, les idées d'amélioration ne manquent pas. Mais impossible de savoir si une modification va améliorer ou dégrader les choses tant qu'on ne l'a pas essayée. Et même si vos chiffres progressent après un changement, il est souvent impossible de dire si le mérite en revient au changement ou si vous avez simplement augmenté votre budget publicitaire cette semaine-là.
Quand vous voulez confirmer l'effet d'une modification indépendamment des autres facteurs, vous utilisez un test A/B.
Cet article explique ce que signifie le test A/B et comment il fonctionne, puis aborde les étapes concrètes, la rédaction d'une hypothèse, la quantité de données et le temps nécessaires, ce que signifie vraiment « différence significative » et les erreurs les plus fréquentes des débutants. Quelques statistiques apparaissent, mais je limite les formules au strict minimum et je privilégie la compréhension des idées. Tous les exemples de calcul de cet article reposent sur des chiffres hypothétiques choisis à titre d'illustration.
Qu'est-ce qu'un test A/B ?
Le test A/B est une méthode qui consiste à montrer de façon aléatoire à chaque visiteur l'une de deux versions d'une page et à comparer laquelle produit les meilleurs résultats, à partir de données recueillies sur la même période. On parle parfois aussi de « split testing ».
- A (contrôle / version d'origine) : la page actuelle. C'est la référence de comparaison
- B (variante / version modifiée) : une page dont une partie a été changée. C'est l'idée que vous voulez essayer
Par exemple, vous montrez la version A à la moitié de vos visiteurs et la version B à l'autre moitié, puis vous comparez la part de chaque groupe qui a terminé une inscription. Cette part s'appelle le taux de conversion (CVR). Une conversion est une action que vous souhaitez voir les visiteurs accomplir sur votre site, comme un achat, une inscription ou une demande de documentation.
Le nom « test A/B » vient de la comparaison de deux versions, mais vous pouvez aussi en comparer trois ou plus à la fois (on parle alors de test A/B/n). L'idée est la même.
Fonctionnement : répartir au hasard et comparer en même temps
Trois mécanismes font fonctionner un test A/B.
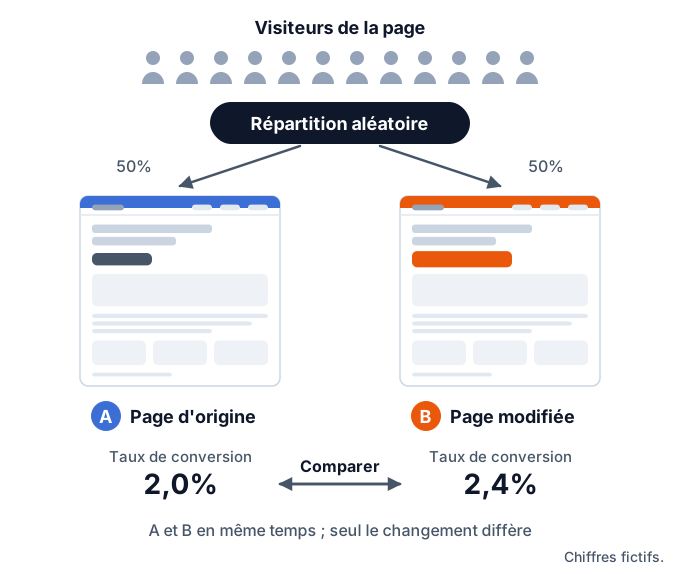
1. Les visiteurs sont attribués au hasard. C'est l'outil qui décide, à l'aide de nombres aléatoires, si un visiteur voit A ou B. Aucune personne ne choisit, et la répartition ne suit pas une règle du type « A le matin, B l'après-midi ». Grâce à l'attribution aléatoire, les différences entre visiteurs, comme nouveaux ou récurrents, smartphone ou ordinateur, venant de la publicité ou venant de la recherche, se retrouvent mélangées à peu près dans les mêmes proportions dans A et dans B.
2. Les deux versions tournent pendant la même période. A et B sont diffusées en même temps. Les influences extérieures telles que les soldes, les saisons, un passage à la télévision ou les variations selon le jour de la semaine touchent donc A et B de la même manière.
3. Une même personne continue de voir la même version. Si quelqu'un affecté à B voit A lors de sa visite suivante, il devient impossible de savoir quelle version a influencé son inscription. C'est pourquoi la plupart des outils utilisent un marqueur enregistré dans le navigateur (comme un cookie) pour continuer à montrer la même version au même visiteur.
Lorsque ces trois conditions sont réunies, la seule différence entre A et B est « ce que vous avez modifié sur la page ». C'est pourquoi, quand les résultats diffèrent, il est plus facile d'attribuer l'écart à la modification. C'est la même idée que les essais contrôlés randomisés utilisés pour tester l'effet des médicaments, appliquée aux sites web.
Pourquoi faire des tests A/B : ce qu'une comparaison avant/après ne peut pas vous dire
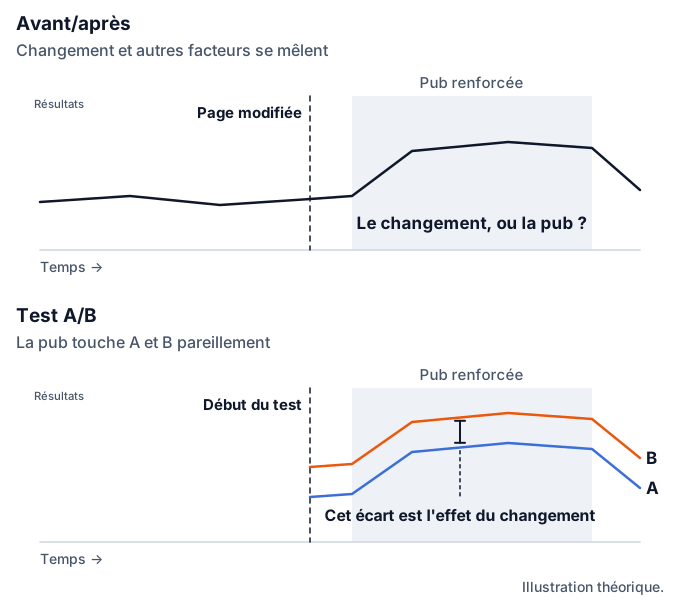
Vous vous demandez peut-être : « Pourquoi ne pas simplement modifier la page et comparer les chiffres avant et après, sans répartir les visiteurs ? » C'est ce qu'on appelle une comparaison avant/après. C'est simple, mais elle a un gros défaut : on ne peut pas séparer l'effet de la modification de celui d'autres facteurs.
Les chiffres de votre site bougent d'un jour à l'autre même si vous ne changez rien à la page. Parmi les facteurs qui les font varier :
- Saisons et événements : période des primes, clôture de l'exercice, jours fériés, météo, etc.
- Publicité et campagnes : hausse ou baisse du budget publicitaire, changement de page de destination des annonces, envoi de newsletters
- Jour de la semaine et heure de la journée : les visiteurs en semaine et le week-end peuvent différer par leur profil et leur objectif
- Évolution des sources de trafic : changements de positionnement dans les moteurs de recherche, buzz sur les réseaux sociaux, recommandations d'autres sites
- Concurrents et marché : baisse de prix d'un concurrent, couverture médiatique
Dans une comparaison avant/après, si l'un de ces facteurs coïncide avec la période qui suit votre modification, vous ne pouvez pas dire si la variation des chiffres vient de votre changement ou d'autre chose. Même si les chiffres ont augmenté après la modification, il se peut que le changement lui-même ait nui et qu'une hausse de la publicité l'ait masqué.
Un test A/B diffuse A et B pendant la même période, de sorte que ces facteurs affectent les deux de la même manière. Vous examinez ensuite l'écart restant, ce qui permet d'isoler plus facilement l'effet de la seule modification.
Une autre raison tient au fait que l'intuition de celui qui conçoit la page et les réactions des visiteurs ne coïncident souvent pas. Il n'est pas rare qu'une idée que tout le monde en interne jugeait « plus facile à comprendre » tombe à plat auprès de vrais visiteurs. Le test A/B est aussi un moyen de décider d'après ce que font réellement les visiteurs, et non d'après celui qui argumente le plus fort ou qui a le titre le plus élevé.
Ce que le test A/B peut et ne peut pas vous dire
Le test A/B est puissant, mais il ne peut pas tout vous apprendre. Savoir avant de commencer ce qu'il fait bien et mal vous aide à éviter de mal interpréter les résultats.
Ce qu'il peut vous dire
- Si une modification a fait monter, baisser ou à peine bouger l'indicateur que vous avez choisi (comme le taux d'inscription)
- Si l'écart est assez grand pour que les seules variations aléatoires aient du mal à l'expliquer
Ce qu'il ne peut pas vous dire, ou ce pour quoi il n'est pas adapté
- Pourquoi il y a eu un écart : la raison relève de la supposition. Examinez-la avec d'autres données
- Les effets à long terme : il ne voit que le comportement pendant la période de test. Il ne peut souvent pas vous renseigner sur la fidélisation ou les taux de résiliation plusieurs mois plus tard
- La comparaison avec des idées que vous n'avez pas testées : vous apprenez lequel de A et de B est le meilleur, mais pas s'il existe une option C encore meilleure
- Les petites améliorations sur des pages à faible trafic : il peut ne pas y avoir assez de données pour trancher, qu'il existe un écart ou non (la section consacrée à ce cas plus bas explique quoi faire)
Par ailleurs, le test A/B est « un outil pour vérifier des idées », et non « un outil pour trouver de bonnes idées ». La qualité des idées que vous testez dépend de la façon dont vous construisez vos hypothèses.
Les types de tests A/B : différences avec les tests multivariés et les tests de redirection
Même au sein du « test A/B », il existe plusieurs méthodes voisines. Voici celles qui reviennent le plus souvent.
| Type | Ce qu'il compare | Convient surtout pour | Points d'attention |
|---|---|---|---|
| Test A/B | Des versions à la même URL dont une partie est modifiée | Vérifier l'effet d'un seul changement, comme un titre, un bouton ou une image | La forme de base. Commencez par là |
| Test A/B/n | Trois versions ou plus | Vous avez plusieurs candidats de titre et voulez les comparer en une seule fois | Plus il y a de versions, moins il y a de données par version et plus le test est long |
| Test multivarié | Des combinaisons de plusieurs éléments (p. ex. 2 titres × 2 images = 4 combinaisons) | Vous voulez savoir quelle combinaison d'éléments fonctionne le mieux | Il faut des données pour chaque combinaison. Adapté aux pages à fort trafic |
| Test de redirection (split URL test) | Des pages de conception différente créées à des URL distinctes | Vous voulez comparer une nouvelle page à la mise en page très différente avec la page actuelle | La redirection peut retarder légèrement l'affichage. Il faut tenir compte des moteurs de recherche |
| Test A/A | Deux versions identiques | Vous voulez vérifier que la répartition du trafic et la mesure de l'outil fonctionnent correctement | Un test de contrôle, pas d'amélioration |
Un test multivarié modifie plusieurs éléments à la fois et compare les résultats de chaque combinaison. Il peut même montrer comment les éléments fonctionnent ensemble, par exemple « ce titre associé à cette image est la meilleure combinaison ». Cependant, 3 titres, 3 images et 2 boutons font 18 combinaisons, et chacune a besoin de suffisamment de données. Pour les sites au trafic limité, enchaîner des tests A/B les uns après les autres est plus réaliste.
Un test de redirection envoie une partie des visiteurs vers une autre URL et compare les résultats ; on l'appelle aussi split URL test. Il convient aux changements importants, comme la refonte de la structure même de la page. Un test A/B classique, qui réécrit des éléments à la même URL, convient pour essayer rapidement de petits changements comme un libellé ou une couleur.
En dehors du web, envoyer deux versions d'un objet d'e-mail ou d'une publicité et comparer les réactions s'appelle aussi du test A/B. Cet article traite du test A/B de pages web.
Que tester dans un test A/B
Les éléments que l'on peut tester sont nombreux. Voici les plus typiques.
- Titre (accroche principale) : passer d'une description des fonctionnalités à une description du résultat que le visiteur obtient. L'objectif est de faire comprendre « cela me concerne » dès les premières secondes
- CTA (bouton d'appel à l'action) : changer le libellé, la position, la taille ou la couleur. L'objectif est de rendre l'action suivante claire
- Image ou vidéo principale : comparer une photo du produit seul avec une photo du produit en situation d'usage. L'objectif est de transmettre la valeur de façon intuitive
- Formulaires : réduire le nombre de champs, découper en étapes, ajouter un exemple de saisie. L'objectif est de réduire l'effort et l'hésitation
- Présentation des prix : disposition des prix mensuels et annuels, ordre des offres, emplacement des prix TTC. L'objectif est de faciliter la comparaison et la décision
- Éléments de réassurance : références clients, témoignages, emplacement des informations sur la garantie et le support. L'objectif est de réduire l'inquiétude avant l'inscription
- Mise en page et ordre des informations : remonter les informations clés, raccourcir une longue page. L'objectif est d'aider les visiteurs à atteindre plus vite l'information dont ils ont besoin
- Navigation : changer le nombre d'éléments du menu ou leur libellé. L'objectif est de réduire la confusion et de guider les visiteurs vers la page qu'ils cherchent
CTA signifie « Call To Action » (appel à l'action). Il désigne un bouton ou un lien qui incite le visiteur à agir, comme « S'inscrire » ou « Demander la documentation ».
En règle générale, choisissez par où commencer selon la proximité avec le résultat et la quantité de visiteurs qui le voient. Les endroits directement liés aux résultats, comme les boutons d'inscription et les formulaires, ainsi que le haut de la page que voient beaucoup de visiteurs, sont ceux où les changements ont le plus de chances de produire un effet. À l'inverse, un petit changement vers le bas d'une page que la plupart des gens n'atteignent jamais met longtemps à être détecté, même s'il fonctionne.
La « couleur du bouton » est souvent citée comme exemple de test A/B, mais un simple changement de couleur ne produit pas forcément une grande différence. Ce qui compte plus que la couleur elle-même, c'est de savoir si le problème est que le bouton se fond dans son environnement et passe inaperçu. Ce qu'il faut changer doit se déduire de l'hypothèse, que nous abordons ensuite.
Comment mener un test A/B [6 étapes]
Un test A/B se déroule en 6 étapes. L'essentiel est de fixer l'indicateur, la quantité de données nécessaire, la durée et les critères d'analyse avant de lancer le test.
Définir l'objectif et l'indicateur
Concentrez-vous sur une seule chose à améliorer et choisissez l'indicateur qui la mesure. Formulez-la de façon mesurable en chiffres, par exemple « augmenter le taux de finalisation des demandes de documentation ». N'utilisez qu'un seul indicateur pour trancher (l'indicateur principal).
Formuler une hypothèse
Écrivez « où se situe le problème, ce que vous allez changer et comment, et pourquoi vous pensez que cela améliorera les choses ». S'appuyer sur des données comme l'analyse web et les heatmaps réduit la part de supposition.
Créer la variante à tester
À partir de l'hypothèse, créez la version modifiée (B). Pour pouvoir identifier ce qui a fonctionné, limitez les changements à ce que couvre une seule hypothèse. Vérifiez l'affichage sur smartphone comme sur ordinateur.
Fixer les données et la durée nécessaires, puis lancer
Estimez la taille d'échantillon nécessaire et la durée du test, décidez du taux de diffusion, puis démarrez. Juste après le lancement, vérifiez que la répartition du trafic et la mesure fonctionnent correctement.
Analyser une fois la période écoulée
Ne regardez les résultats qu'après avoir atteint la durée et le volume de données fixés à l'avance. Examinez l'écart sur l'indicateur principal et si cet écart reste dans ce que les variations aléatoires pourraient expliquer.
Appliquer le résultat et passer à l'hypothèse suivante
Adoptez officiellement la version qui a fait mieux et nettoyez les réglages du test. Même s'il n'y a pas eu d'écart, consignez ce que vous avez appris et servez-vous-en pour la prochaine hypothèse.
Les sections suivantes détaillent la logique de chaque étape.
Comment choisir l'objectif et les indicateurs
Il est utile d'organiser les indicateurs selon leur rôle.
- Indicateur principal : celui qui décide du gagnant du test. N'en choisissez qu'un. Par exemple le taux de finalisation d'achat, le taux de finalisation des demandes de documentation ou le taux d'inscription gratuite
- Indicateurs secondaires : ceux que vous regardez pour comprendre comment l'indicateur principal a évolué. Par exemple le taux de clic sur le bouton, le taux de début de formulaire et la profondeur de défilement
- Indicateurs de garde-fou : ceux que vous surveillez pour vous assurer que rien ne s'est dégradé. Par exemple le taux de rebond, la vitesse de chargement de la page, les retours ou résiliations et le nombre de demandes de contact
On se limite à un seul indicateur principal parce que, si vous alignez de nombreux indicateurs et criez victoire dès que l'un d'eux s'améliore, vous risquez de retenir un indicateur qui avait l'air meilleur uniquement par hasard. C'est le problème des « comparaisons multiples », que nous retrouverons dans une section ultérieure.
Choisissez un indicateur principal aussi proche que possible des résultats de l'entreprise. Il arrive que le taux de clic sur le bouton monte sans que les inscriptions augmentent. Un libellé incitatif pousse plus de gens à cliquer, mais si la suite ne correspond pas à leurs attentes, ils s'en vont.
En revanche, les indicateurs rares, comme les achats ou les contrats, demandent plus de temps pour rassembler assez de données. Pour les sites au trafic limité, une option consiste à prendre comme indicateur principal un indicateur situé plus tôt dans le parcours (comme l'arrivée sur le formulaire). Dans ce cas, il est important de garder en tête que « même si l'indicateur amont s'améliore, le résultat final ne s'améliorera pas forcément ».
Comment rédiger une hypothèse : transformer des données de comportement en raison de changer
Le succès d'un test A/B dépend largement de la qualité de l'hypothèse. Si vous enchaînez les idées sans hypothèse, vous vous retrouvez avec une série de tests qui ne montrent aucun écart, et même quand il y en a un, vous ne pouvez pas capitaliser dessus.
Rédiger l'hypothèse sous la forme suivante réduit les lacunes.
« D'après (un fait observé dans les données), nous pensons que (une supposition sur le problème). Donc si nous (faisons ce changement), (cet indicateur) devrait s'améliorer. »
Prenons comme exemple la situation suivante (hypothétique).
- Fait : sur la page de tarifs, peu de visiteurs font défiler la page assez loin pour atteindre le bouton d'inscription
- Supposition sur le problème : le bouton est trop bas, si bien que même les visiteurs qui veulent s'inscrire ne le trouvent pas
- Changement : placer aussi un bouton d'inscription juste sous le tableau des offres
- Indicateur : taux de finalisation de l'inscription
Écrire les choses ainsi vous permet, une fois les résultats connus, de vous demander si « la supposition était fausse ou si le changement n'était pas suffisant ».
Les données qui peuvent alimenter une hypothèse comprennent les suivantes.
- L'analyse web : quelles pages perdent beaucoup de visiteurs, quelles sources de trafic donnent de faibles résultats. Utile pour trouver quelle « page » pose problème
- Les heatmaps : jusqu'où les gens lisent la page, où ils cliquent, s'ils cliquent sur des éléments qui ne sont pas des liens. Utile pour trouver quel « endroit » pose problème
- Les demandes de contact et les comptes rendus des équipes commerciales ou du support : ce qui déroute et inquiète les visiteurs
- Les enquêtes et entretiens avec les utilisateurs : des indices sur les raisons qui n'apparaissent pas dans les chiffres
Une heatmap est un outil qui superpose le comportement des visiteurs à la page sous forme de zones plus ou moins foncées (voir Qu'est-ce qu'une heatmap ? pour les types et la façon de la lire). Elle aide à repérer les points problématiques dans une page, comme « un bouton important n'est pas cliqué » ou « beaucoup de gens arrêtent de lire à mi-page ». Pour la répartition des rôles, où l'on trouve les problèmes avec une heatmap et où l'on vérifie la correction avec un test A/B, voir Heatmaps et tests A/B : différences et usages.
Quand vous avez plusieurs hypothèses, classez-les selon trois critères : « ampleur attendue de l'impact », « solidité des preuves » et « effort de mise en œuvre ». Commencer par celles dont l'impact attendu est élevé et l'effort faible facilite l'avancement.
Comprendre la taille d'échantillon
La taille d'échantillon est la quantité de données nécessaire au test, c'est-à-dire le nombre de visiteurs qui ont vu chaque version. Dans un test A/B, on l'estime avant de lancer le test. Si les données sont trop peu nombreuses, vous manquerez plus souvent un écart qui existe réellement, et même lorsqu'un écart significatif apparaît par hasard, sa taille a tendance à paraître plus grande qu'elle ne l'est vraiment.
La taille d'échantillon nécessaire est déterminée principalement par ces quatre éléments.
- Le taux de conversion actuel : plus il est bas, plus il faut de données
- La taille de l'écart que vous voulez détecter : plus l'écart recherché est petit, plus il faut de données. Le plus petit écart que vous voulez pouvoir détecter, en acceptant de manquer tout ce qui est plus petit, s'appelle l'effet minimal détectable (MDE)
- Le seuil de significativité : la part de l'erreur consistant à déclarer « il y a un écart » alors qu'il n'y en a pas que vous acceptez. 5 % est couramment utilisé
- La puissance statistique : la probabilité de trouver un écart quand il existe réellement. 80 % est couramment utilisé
Parmi ces éléments, le deuxième est celui qui pèse le plus. Quand l'écart que vous voulez trouver est divisé par deux, la quantité de données nécessaire est multipliée par environ 4.
Voici un exemple de calcul pour donner un ordre de grandeur. Ce sont des nombres approximatifs de visiteurs nécessaires par variante, en supposant un taux de conversion actuel de 2,0 % (calculés avec une formule standard de comparaison de deux proportions, avec un test bilatéral, un seuil de significativité de 5 % et une puissance de 80 %).
| Amélioration à détecter (relative) | Taux de conversion après le changement | Visiteurs nécessaires par variante (approx.) |
|---|---|---|
| +10% | 2,0 % → 2,2 % | environ 80 700 |
| +20% | 2,0 % → 2,4 % | environ 21 100 |
| +30% | 2,0 % → 2,6 % | environ 9 800 |
| +50% | 2,0 % → 3,0 % | environ 3 800 |
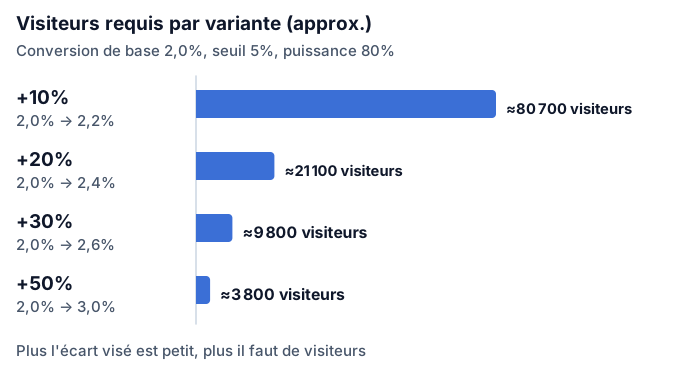
Ce tableau montre deux choses. D'abord, confirmer une petite amélioration demande plus de données qu'on ne le croit. Pour confirmer une amélioration de 10 % sur une page dont le taux de conversion est de 2,0 %, il faudrait plus de 160 000 visiteurs au total pour A et B. Ensuite, plus l'amélioration visée par un changement est grande, moins il faut de données pour en juger.
Au moment d'estimer concrètement, les calculateurs intégrés aux outils de test A/B ou les calculateurs de taille d'échantillon accessibles publiquement vous donnent la réponse en saisissant simplement les quatre valeurs. Inutile de mémoriser la formule. L'essentiel est de décider d'abord « quel écart je veux trouver », puis de vérifier si le trafic de votre site permet d'y arriver dans un délai réaliste.
Si le nombre nécessaire que vous estimez est trop élevé, il existe d'autres options que renoncer à tester : miser sur un changement susceptible de produire un écart plus grand, mener le test sur une page à fort trafic ou observer un indicateur situé plus tôt dans l'entonnoir. La section « Que faire sur un site à faible trafic » explique comment.
Comment déterminer la durée du test
Estimez la durée du test en divisant la taille d'échantillon nécessaire par le nombre de personnes qui visitent la page testée chaque jour.
Voici un exemple. Supposons que le tableau ci-dessus indique qu'il faut « environ 21 100 par variante ». Disons que la page cible reçoit 1 000 visiteurs par jour, et supposons que tout le monde soit inclus dans le test et réparti moitié-moitié entre A et B, soit 500 par jour pour chaque variante. 21 100 ÷ 500 donne environ 42 jours, soit environ 6 semaines.
Pour fixer la durée, tenez compte des points suivants en plus de la quantité de données.
Utilisez des semaines entières. Le comportement des visiteurs varie selon le jour de la semaine. En semaine, il peut s'agir de recherches professionnelles et le week-end d'achats personnels, de sorte que le profil et l'objectif des visiteurs peuvent différer. Si vous terminez après seulement quatre jours, du lundi au jeudi, les réactions des visiteurs du week-end manquent. Commencer et finir le même jour de la semaine, en multiples de 7 jours, évite le biais lié au jour de la semaine.
Évitez une période trop courte. Même sur des sites à très fort trafic qui atteignent le nombre requis en quelques jours, une règle empirique courante est de laisser tourner au moins 1 semaine, idéalement 2 semaines. Outre le biais du jour de la semaine, les réactions peuvent être meilleures juste après un changement simplement parce qu'il est nouveau (ou moins bonnes parce que les visiteurs récurrents sont déroutés).
Évitez aussi une période trop longue. Plus un test dure, plus des perturbations s'insinuent, comme des cookies supprimés qui font qu'une même personne voit une autre version, ou des saisons et des conditions de marché qui changent. Si votre estimation dépasse largement 2 mois, nous vous recommandons de revoir la conception du test (la taille de l'écart à détecter, la page cible et l'indicateur).
Évitez les périodes inhabituelles. Les résultats de périodes où le comportement des visiteurs est très différent de l'ordinaire, comme les grandes soldes ou les fêtes de fin d'année, peuvent ne pas s'appliquer aux périodes normales. À moins de vouloir vérifier une action propre à cette période, il est plus prudent de les éviter.
Qu'est-ce que la significativité statistique ? Explication simple des p-values et des niveaux de confiance
Quand le test se termine, vous obtenez un résultat du type « A est à 2,0 %, B est à 2,4 % ». Ce qu'il faut examiner ici, c'est si cet écart est réel ou dû au hasard.
Même si vous montrez exactement la même page à deux groupes, leurs taux de conversion ne coïncideront presque jamais exactement. De même que lancer une pièce 100 fois ne donne pas toujours exactement 50 faces, les chiffres comportent des variations aléatoires. Il faut donc une procédure pour vérifier si « l'écart observé reste dans ce que les seules variations aléatoires pourraient expliquer ». C'est le test d'hypothèse statistique, et le terme désignant sa conclusion est la significativité statistique.
Qu'est-ce qu'une p-value ?
Dans un test, on suppose d'abord qu'« il n'y a réellement aucun écart entre A et B ». On calcule ensuite la probabilité d'observer par hasard un écart au moins aussi grand que celui observé, s'il n'y avait réellement aucun écart. Cette probabilité est la p-value.
- Une petite p-value → sous l'hypothèse d'absence d'écart, un écart comme celui-ci se produirait rarement → l'hypothèse d'absence d'écart paraît douteuse
- Une grande p-value → un écart de cette taille apparaît souvent par hasard même sans écart réel → on ne peut pas dire qu'il y a un écart
Seuil de significativité et niveau de confiance
Le seuil indiquant à partir de quelle petite valeur de la p-value on conclut « il y a un écart » s'appelle le seuil de significativité. Par convention, 5 % (0,05) est couramment utilisé. Quand la p-value passe sous le seuil de significativité, on dit qu'« il y a un écart statistiquement significatif ».
Sur les écrans des outils de test A/B, on voit souvent des affichages comme « niveau de confiance de 95 % » ou « confiance de 95 % ». Cela signifie généralement que l'outil juge avec un seuil de significativité de 5 % (le sens de l'affichage varie selon les outils, vérifiez donc la documentation de votre outil).
Un seuil de significativité de 5 % est une convention selon laquelle « on accepte jusqu'à 5 % de chances de déclarer un écart alors qu'il n'y en a pas réellement ». Autrement dit, si vous testez 20 changements sans aucun effet, en moyenne 1 d'entre eux ressortira comme « significatif ». Un écart significatif n'est pas une preuve de certitude ; c'est un repère pour maintenir la probabilité d'erreur sous un niveau fixé.
Idées reçues courantes sur la p-value
Parmi les autres idées reçues courantes figurent les suivantes.
- « Non significatif » ne veut pas dire « il n'y a pas d'écart » : cela inclut la situation où il n'y a pas assez de données pour dire si un écart existe
- Un écart significatif n'a pas forcément une taille qui compte pour votre activité : avec une très grande quantité de données, même un écart minuscule devient significatif. Regardez aussi la taille de l'écart
- Une p-value plus petite ne signifie pas un effet plus grand : la p-value dépend aussi de la quantité de données
Vérification avec des exemples de calcul
Vérifions avec des chiffres hypothétiques. Supposons que 10 000 visiteurs soient attribués à A et à B chacun.
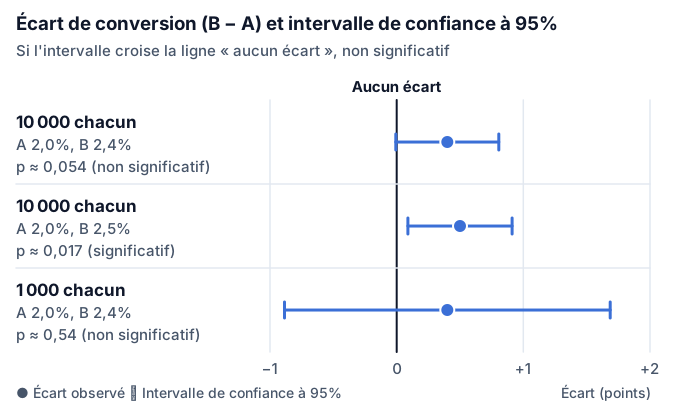
- Exemple 1 : A compte 200 conversions (2,0 %) et B en compte 240 (2,4 %). La p-value est d'environ 0,054, juste au-dessus du seuil de significativité de 5 %. Même si un écart relatif de 20 % est visible, on ne peut pas parler de « significatif » avec cette quantité de données
- Exemple 2 : A compte 200 conversions (2,0 %) et B en compte 250 (2,5 %). La p-value est d'environ 0,017, sous le seuil de significativité de 5 %
Avec les mêmes taux, la conclusion change s'il y a moins de données. Si A et B avaient chacune 1 000 visiteurs, avec 20 conversions (2,0 %) pour A et 24 (2,4 %) pour B, la p-value serait d'environ 0,54. Cela signifie que, même sans écart réel, un écart de cette taille apparaît par hasard plus d'une fois sur deux.
(Tous ces exemples sont calculés avec un test bilatéral de la différence entre deux proportions. Pour les décisions réelles, suivez la méthode utilisée par votre outil.)
Regardez aussi l'intervalle de confiance
Une p-value tend à se réduire à une question de « significatif ou non », mais l'intervalle de confiance donne une idée de la taille de l'écart. Un intervalle de confiance est une plage dans laquelle l'écart réel est considéré comme susceptible de se situer.
Dans l'exemple 1 ci-dessus, la différence de taux de conversion (B moins A) est de 0,4 point de pourcentage, et l'intervalle de confiance à 95 % est d'environ −0,01 à +0,81 point de pourcentage. Comme l'intervalle franchit tout juste zéro, on peut le lire ainsi : « B semble meilleure, mais on ne peut pas exclure qu'il n'y ait pas d'écart ». Un intervalle large indique que vous n'avez pas encore assez de données.
Certains outils affichent la « probabilité que B batte A »
Certains outils affichent un nombre du type « la probabilité que B batte A » au lieu d'une p-value. Cette valeur repose sur une approche différente appelée statistique bayésienne, et ses hypothèses et sa signification diffèrent de celles d'une p-value. Aucune des deux n'est simplement juste ou fausse ; ce sont deux écoles de pensée différentes. L'essentiel est de vérifier quelle méthode produit le nombre que vous regardez et de ne pas les confondre comme s'il s'agissait du même type de nombre.
Comment lire les résultats et que faire après le test
Une fois la période terminée, examinez les résultats dans cet ordre.
- Si la répartition du trafic s'est déroulée comme prévu : si vous avez réglé une répartition moitié-moitié, les nombres de visiteurs de A et de B sont-ils très déséquilibrés ? En cas de fort déséquilibre, il peut y avoir un problème de répartition ou de mesure, et il est dangereux de se fier aux résultats tels quels
- L'écart sur l'indicateur principal et sa significativité : le sens de l'écart, sa taille, la p-value et l'intervalle de confiance
- Les indicateurs de garde-fou : alors que l'indicateur principal s'est amélioré, d'autres chiffres importants se sont-ils dégradés ?
- Les indicateurs secondaires : des indices pour réfléchir à la raison de ce résultat
Les résultats se répartissent en trois grands cas.
B était significativement meilleure. Adoptez officiellement B. Continuez à surveiller les chiffres un certain temps après l'application pour confirmer que la même tendance se poursuit comme pendant le test.
B était significativement moins bonne. Restez sur A. Ce n'est pas un échec ; le résultat est que vous avez arrêté un mauvais changement avant de le montrer à tout le monde. Réfléchir aux raisons de ce moins bon résultat améliorera la précision de votre prochaine hypothèse.
Il n'y avait pas d'écart significatif. En test A/B, c'est l'un des résultats les plus fréquents. Dans ce cas, évitez de « prolonger le test jusqu'à ce qu'il devienne significatif » une fois la période prévue écoulée (la section suivante en explique la raison). Quand il n'y a pas d'écart, distinguez si l'hypothèse était fausse, si le changement était trop petit ou si les données étaient insuffisantes. Si les résultats sont identiques dans les deux cas, vous pouvez choisir la version la plus facile à exploiter ou la plus conforme à votre charte de marque.
Examiner les résultats ventilés par appareil ou par source de trafic (analyse par segments) est également utile, mais exige de la prudence. Plus vous découpez finement, moins chaque groupe contient de données, et plus vous captez facilement des écarts dus au hasard. Il est plus prudent de traiter les tendances trouvées en découpant comme des « hypothèses à vérifier ensuite » et non comme des « conclusions ».
Enfin, conservez une trace du test. Réunir au même endroit l'hypothèse, les changements, la durée, la quantité de données, les résultats et les enseignements évite de refaire le même test et transmet ce que vous avez appris même quand la personne responsable change.
Erreurs courantes en test A/B et comment les éviter
Comme le mécanisme du test A/B est simple, s'y prendre mal peut produire une conclusion fausse accompagnée de chiffres d'apparence crédible. Voici les erreurs typiques.
| Erreur courante | Où est le problème | Solution |
|---|---|---|
| Vérifier les résultats sans cesse et s'arrêter dès qu'ils deviennent significatifs | L'erreur consistant à qualifier de « significatif » un écart dû au hasard devient plus fréquente que le seuil de significativité que vous avez fixé | Fixez à l'avance les données et la durée nécessaires, et tranchez une fois qu'elles sont atteintes |
| Changer de nombreux éléments à la fois | Même s'il y a un écart, vous ne pouvez pas savoir ce qui a fonctionné | Limitez les changements à ce que couvre une seule hypothèse |
| Une période de test courte | Les résultats sont faussés par le biais du jour de la semaine et les réactions temporaires juste après le changement | Menez le test par multiples de 7 jours, au moins 1 à 2 semaines |
| Trancher avec un faible trafic | Les variations aléatoires sont fortes et les conclusions instables | Estimez à l'avance le nombre nécessaire et repensez la conception s'il est insuffisant |
| Biais du jour de la semaine ou de la saison | Des résultats obtenus uniquement en semaine ou uniquement pendant une période de soldes ne s'appliquent pas aux périodes normales | Commencez et finissez le même jour de la semaine et évitez les périodes inhabituelles |
| Aligner de nombreux indicateurs et de nombreuses variantes, puis ne retenir que le bon | Plus vous faites de comparaisons, plus il est probable que quelque chose paraisse bon par hasard | Choisissez un seul indicateur principal et limitez le nombre de variantes |
| Tester sans hypothèse | Même avec des résultats, aucun apprentissage ne subsiste sur lequel s'appuyer | Écrivez le fait, le problème, le changement et l'indicateur avant de commencer |
| Modifier les réglages ou les variantes en cours de route | La nature des données change avant et après, elles ne sont donc plus comparables | Si vous voulez changer quelque chose, arrêtez et recommencez comme un nouveau test |
La première erreur est celle dont il faut se méfier tout particulièrement : le problème du « peeking » (coup d'œil). Consulter l'avancement intermédiaire d'un test presque chaque jour est en soi nécessaire pour repérer rapidement les problèmes. Le problème, c'est d'arrêter le test et de proclamer une victoire dès que les résultats intermédiaires montrent un écart significatif.
Une p-value oscille à la hausse et à la baisse à mesure que les données s'accumulent. Même quand il n'y a réellement aucun écart, si vous vérifiez de nombreuses fois, il peut arriver à un moment qu'elle passe sous le seuil de significativité par hasard. Si vous vous arrêtez à ce moment-là, l'« erreur consistant à déclarer un écart alors qu'il n'y en a pas » devient plus fréquente que les 5 % prévus. La règle qui consiste à attendre, pour trancher, d'avoir atteint le volume de données et la durée fixés à l'avance existe pour éviter cette erreur.
Certains outils proposent aussi une méthode d'analyse conçue pour que les erreurs n'augmentent pas même si l'on tranche en cours de route (comme ce que l'on appelle les tests séquentiels). Dans ce cas, suivez la procédure indiquée par l'outil.
Un mot également sur le fait de « changer beaucoup de choses à la fois ». Même si une version B qui change à la fois le titre, l'image et le bouton l'emporte, vous ne saurez pas lequel a fonctionné. Il est possible que le titre ait été bon mais que l'image l'ait tiré vers le bas. En revanche, si votre objectif est de comparer une page entièrement refondue avec la page actuelle, changer les éléments ensemble a du sens. Dans ce cas, acceptez de « ne pas savoir quel élément a fonctionné » et comparez-les avec quelque chose comme un test de redirection.
Taux de diffusion et répartition A/B : comment y réfléchir
Deux réglages en « pourcentage » apparaissent quand vous configurez un test A/B. Ils se confondent facilement, comprenez-les donc séparément.
- Taux de diffusion (la part des visiteurs inclus dans l'expérience) : quel pourcentage de l'ensemble des visiteurs est inclus dans le test. Les visiteurs en dehors du test voient simplement la page d'origine
- Répartition A/B : dans quelle proportion les visiteurs inclus dans le test sont répartis entre A et B
Par exemple, si vous réglez le taux de diffusion à 20 % et la répartition A/B à moitié-moitié, 80 % de l'ensemble des visiteurs sont hors du test et voient la page d'origine, 10 % sont dans le test et voient A, et 10 % voient B.
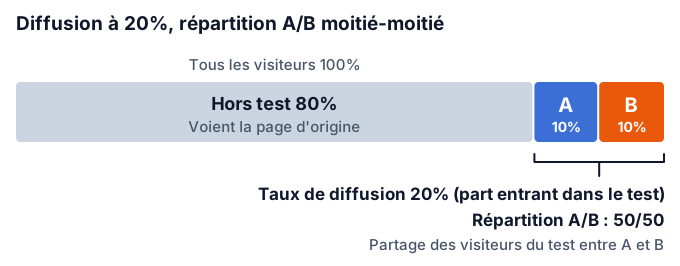
Une répartition A/B moitié-moitié est le réglage par défaut. À nombre de visiteurs égal, une répartition équitable permet de recueillir le plus vite les données nécessaires. Vous pouvez aussi donner à B une part plus petite, mais il faut alors attendre que le côté le plus petit recueille assez de données, et la durée s'allonge.
Choisissez le taux de diffusion en équilibrant risque et durée. Abaisser le taux de diffusion réduit le nombre de visiteurs touchés si le changement se retourne contre vous. En contrepartie, moins de visiteurs participent au test, et il faut plus de temps pour recueillir les données nécessaires. Une approche courante consiste à lancer un changement important à l'impact imprévisible avec un faible taux de diffusion, à vérifier qu'il n'y a pas de problème, puis à l'élargir si tout va bien. Pour un changement à faible impact, comme remplacer quelques mots, il est plus judicieux d'inclure tout le monde dès le départ et de raccourcir la durée.
La différence entre ces deux pourcentages est expliquée dans Taux de diffusion et répartition A/B dans un test A/B, et la réflexion de conception est abordée dans Pourquoi le taux de diffusion et la répartition A/B doivent être deux réglages distincts.
Test A/B et SEO : limiter l'impact sur le référencement
Une inquiétude fréquente est de savoir si « le test A/B va nuire à mon classement dans les moteurs de recherche ». Google publie des recommandations pour mener des tests en limitant l'impact sur la recherche, dans la documentation Google Search Central. Les points essentiels sont les suivants.
- Ne faites pas de cloaking : montrer intentionnellement un contenu différent aux robots des moteurs de recherche (les programmes qui visitent et lisent les pages) et aux visiteurs humains s'appelle du cloaking, et cela enfreint les règles anti-spam. C'est vrai qu'un test soit en cours ou non. Évitez tout dispositif qui montre une version particulière uniquement aux robots
- Utilisez rel="canonical" pour les tests sur des URL distinctes : lorsque vous testez sur plusieurs URL, comme dans un test de redirection, ajoutez rel="canonical" (une balise qui indique aux moteurs de recherche l'URL à privilégier) aux URL de test pour indiquer que l'URL d'origine est la page à prioriser. Pour cet usage, Google recommande rel="canonical" plutôt que noindex
- Utilisez des redirections temporaires (302) pour rediriger : pour rediriger de l'URL d'origine vers une URL de test, utilisez 302, qui signale une redirection temporaire, plutôt que 301, qui signale une redirection permanente. Une redirection JavaScript est aussi réputée acceptable
- Ne laissez tourner le test que le temps nécessaire : une fois assez de données recueillies, terminez le test et supprimez dès que possible les URL de test, les scripts, etc. Google explique que laisser un test tourner plus longtemps que nécessaire peut être interprété comme une tentative de tromper les moteurs de recherche
Autrement dit, ne pas laisser traîner les tests est important non seulement sur le plan statistique mais aussi pour la recherche. Menez tout le processus à son terme : nettoyez les tests terminés et appliquez la version adoptée au site lui-même.
Notez que ce qui est présenté ici est un aperçu des recommandations publiées par Google. L'effet sur le classement dans les moteurs de recherche varie selon les sites ; avant de mener un test impliquant un changement important, nous vous recommandons donc de consulter aussi le document d'origine et la documentation de votre outil.
Que faire sur un site à faible trafic
Comme nous l'avons vu dans la section sur la taille d'échantillon, le test A/B demande une quantité de données non négligeable. Le test A/B n'a-t-il donc aucun sens pour les sites de quelques milliers de visiteurs par mois ? Pas nécessairement. Changer d'approche peut vous donner davantage d'éléments.
Testez de grands changements. Plus l'écart que vous voulez trouver est grand, moins il faut de données. Plutôt que de petits changements comme retoucher le libellé d'un bouton, misez sur des changements susceptibles de produire un grand écart : modifier l'argument central, réorganiser la structure de la page ou réduire fortement les champs d'un formulaire.
Menez les tests sur des pages à fort trafic. Même si le site dans son ensemble a peu de trafic, il devrait y avoir des pages où les visiteurs se concentrent. Choisissez les endroits les plus fréquentés, comme la page d'accueil ou les pages qui reçoivent du trafic publicitaire.
Utilisez un indicateur situé plus tôt dans le parcours. Les achats et les contrats sont peu nombreux, donc détecter un écart prend du temps. Prendre comme indicateur principal une action amont plus fréquente, comme « arriver sur le formulaire » ou « aller sur la page de tarifs », limite les données nécessaires. Gardez simplement en tête qu'une amélioration d'un indicateur amont ne se traduit pas forcément par une amélioration du résultat final.
Limitez-vous à deux variantes. Ajouter une troisième et une quatrième réduit les données par variante. Tant que le trafic est faible, comparez seulement A et B.
Réglez le taux de diffusion à 100 % et la répartition A/B à moitié-moitié. Restreindre l'audience ou utiliser une répartition inégale allonge la durée.
Prévoyez une période plus longue, et acceptez les limites si cela ne suffit toujours pas. Si vous ne pouvez pas atteindre le nombre requis même en prévoyant environ 4 à 8 semaines, il vous faut aussi décider de ne pas insister pour trancher par un test A/B.
Quand le test A/B ne convient pas, d'autres méthodes peuvent aider.
- Observer le comportement avec des heatmaps : même avec peu de trafic, vous pouvez vous faire une idée de « là où les gens ne lisent pas » et « là où ils ne cliquent pas »
- Interroger directement les utilisateurs : le simple fait de faire utiliser l'écran à quelques personnes en observant où elles bloquent révèle de nombreux problèmes
- Corriger sans tester les problèmes évidents : liens cassés, texte difficile à lire, boutons qui ne fonctionnent pas et autres cas où l'on imagine mal que la correction aggrave les choses n'ont pas besoin d'attendre une vérification
Types d'outils de test A/B et comment choisir
Pour mener des tests A/B, vous avez besoin d'un outil qui gère la répartition du trafic, le changement de ce qui est affiché, la mesure et les rapports. Selon leur fonctionnement, il existe deux grands types.
Côté client (client-side)
- Fonctionnement : vous ajoutez une balise (un court extrait de code de mesure) à la page, et une partie de la page est réécrite dans le navigateur du visiteur
- Principalement géré par : les marketeurs et les équipes web. De nombreux outils permettent de créer les changements par des manipulations à l'écran
- Adapté à : des changements visuels comme le texte, les images, les couleurs et la mise en page
- Point d'attention : un « scintillement » (flicker) peut se produire, où l'affichage d'origine est visible un instant avant la réécriture
Côté serveur (server-side)
- Fonctionnement : du code côté serveur change ce qui est montré à chaque visiteur
- Principalement géré par : les ingénieurs. Des modifications de code sont nécessaires
- Adapté à : des changements qui impliquent un traitement en back-end, comme le calcul des prix, le fonctionnement de la recherche ou du tri, et les fonctionnalités d'application
- Point d'attention : la mise en place et l'exploitation demandent un effort de développement
Pour l'usage supposé par cet article, essayer des titres et des boutons sur des pages web, les outils côté client sont les premiers candidats.
Pour choisir un outil, vérifiez les points suivants.
- Si vous pouvez créer les changements par des manipulations à l'écran ou s'il faut écrire du code
- Quelle méthode statistique il utilise pour trancher et comment il affiche les résultats
- Si vous pouvez régler séparément le taux de diffusion et la répartition A/B
- S'il prend en charge les tests de redirection
- Sur quoi repose la tarification (nombre de visiteurs, nombre d'événements suivis, nombre d'utilisateurs, etc.)
- Si vous pouvez le consulter avec les données que vous utilisez pour construire des hypothèses, comme les heatmaps
La fin de Google Optimize
Google Optimize, largement utilisé comme outil de test A/B gratuit, a été arrêté en septembre 2023. Les sites qui utilisaient Google Optimize ont dû migrer vers d'autres outils.
Aujourd'hui, les options sont variées : des outils dédiés au test A/B comme Optimizely, VWO et AB Tasty ; des outils qui associent heatmaps et test A/B, comme les japonais Ptengine et SiTest ; et des plateformes d'expérimentation destinées aux développeurs. Les fonctionnalités et le budget nécessaires varient beaucoup selon la taille de votre site ; il est donc important de choisir ce qui correspond à votre propre usage. Pour connaître les différences de gammes de prix et d'approches entre les principaux outils, voir Panorama des outils de test A/B en 2026.
Continuer à s'améliorer en combinant heatmaps et engagement sur site
Le test A/B apporte davantage lorsqu'il est combiné à d'autres outils que lorsqu'il est utilisé seul.
Le processus d'amélioration est un cycle répété de « repérer → créer une correction → vérifier ».
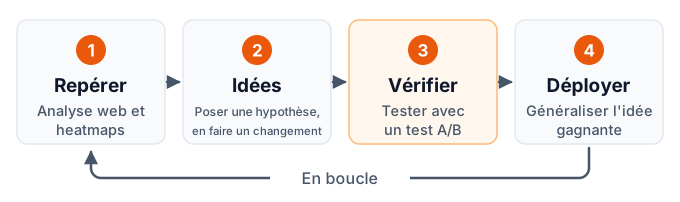
- Repérer : utilisez l'analyse web pour identifier les pages qui posent problème, et les heatmaps pour localiser précisément les points problématiques dans la page
- Créer une correction : formulez une hypothèse à partir du problème repéré et créez le changement
- Vérifier : utilisez un test A/B pour contrôler si le changement améliore réellement les résultats
- Appliquer et passer à la suite : appliquez la version qui a fait mieux, et observez de nouveau la page modifiée avec une heatmap
Consulter une heatmap après l'arrivée des résultats du test A/B est aussi utile. Quand B l'emporte, vérifier comment le comportement des visiteurs a changé (si les gens lisent plus bas, si les endroits où ils cliquent ont bougé) vous donne des indices sur « pourquoi elle était meilleure » et conduit à l'hypothèse suivante.
La logique du test A/B s'applique aussi telle quelle aux actions d'engagement sur site, où, au lieu de changer la page elle-même, vous affichez un message dans un popup ou une barre fixe. Que vous compariez afficher ou ne pas afficher, le libellé ou le moment de l'affichage, le principe est le même : répartir les visiteurs au hasard et comparer sur la même période. Les bases de l'engagement sur site sont expliquées dans Qu'est-ce que l'engagement sur site ?.
À propos de HeatMapX
HeatMapX est un outil qui permet de mesurer des heatmaps en ajoutant une balise à votre site, et vous pouvez commencer avec l'offre gratuite Free (voir la page des tarifs pour le détail des offres). La fonctionnalité de test A/B est déployée par étapes. Commencez par utiliser les heatmaps pour comprendre comment votre propre site est perçu : avoir en tête où expérimenter vous permettra d'avancer vite quand vous commencerez les tests A/B.
Si vous souhaitez comparer les outils de heatmap avec d'autres produits avant de choisir, voir aussi Comparatif des outils de heatmap.
FAQ sur le test A/B
Qu'est-ce que le test A/B, en termes simples ?
C'est une méthode qui consiste à montrer de façon aléatoire à des visiteurs deux versions d'une page pendant la même période et à comparer, chiffres à l'appui, laquelle est la plus performante. Contrairement à une comparaison avant/après un changement, elle permet de vérifier l'effet d'une modification indépendamment d'autres facteurs comme les saisons et la publicité.
Combien de temps un test A/B doit-il durer ?
Estimez-le en divisant la taille d'échantillon nécessaire par le nombre de visiteurs par jour. Pour éviter le biais du jour de la semaine, utilisez des multiples de 7 jours ; une règle empirique courante est de laisser tourner au moins 1 à 2 semaines. Même si un site à fort trafic atteint le nombre requis en quelques jours, nous recommandons de poursuivre pendant une semaine. À l'inverse, si l'estimation dépasse largement 2 mois, revoyez la conception.
De combien de trafic ai-je besoin pour mener un test A/B ?
Il n'existe pas de référence unique. Cela dépend de votre taux de conversion actuel et de la taille de l'écart que vous voulez détecter. Dans l'exemple de calcul de cet article, confirmer une amélioration relative de 20 % sur une page dont le taux de conversion est de 2,0 % demandait environ 21 100 visiteurs par variante. Si votre trafic est faible, vous pouvez réduire le nombre nécessaire en misant sur des changements plus importants ou en utilisant un indicateur situé plus tôt dans le parcours.
Que faire s'il n'y a pas d'écart significatif ?
Évitez de prolonger le test jusqu'à ce qu'il devienne significatif après la période prévue. Consignez que « ce changement n'a pas montré d'écart de la taille que nous voulions détecter », et examinez si l'hypothèse était fausse ou si le changement était trop petit. Si les résultats sont identiques dans les deux cas, vous pouvez choisir la version la plus facile à exploiter. L'absence d'écart significatif n'est pas un échec ; c'est un type de résultat.
Si la p-value est inférieure à 0,05, puis-je dire que B est meilleure ?
Non. Une p-value est « la probabilité d'observer par hasard un écart au moins aussi grand que celui observé, s'il n'y avait réellement aucun écart », et non « la probabilité que B soit meilleure ». Avec un seuil de significativité de 5 %, environ 1 changement sur 20 sans aucun effet montrera tout de même un écart significatif. Vérifiez aussi la taille de l'écart, l'intervalle de confiance et les indicateurs de garde-fou, et, pour les changements importants, continuez à surveiller les chiffres après l'application.
Le test A/B nuit-il au SEO ?
Google publie des recommandations indiquant que l'impact sur la recherche peut être limité si on les suit. Les quatre points clés sont : ne pas montrer de contenu différent aux robots et aux personnes, ajouter rel="canonical" dans les tests sur des URL distinctes, utiliser 302 pour les redirections, et terminer le test et nettoyer les réglages une fois la période nécessaire écoulée. Pour le détail, voir la section « Test A/B et SEO » ci-dessus.
Conclusion : commencez par une hypothèse
Le test A/B est une méthode qui consiste à répartir les visiteurs au hasard et à les comparer pendant la même période, afin de confirmer l'effet d'une modification indépendamment d'autres facteurs. Voici les points clés de cet article.
- Fonctionnement : attribuer les visiteurs au hasard, diffuser les deux versions pendant la même période et continuer à montrer la même version à une même personne. Cela réduit la cause de tout écart à « ce que vous avez modifié »
- Marche à suivre : 6 étapes, objectif et indicateur → hypothèse → création de la variante → lancement → analyse → application. Fixez l'indicateur, la quantité de données, la durée et les critères d'analyse avant de lancer
- Données et durée : plus l'écart que vous voulez confirmer est petit, plus il faut de données. Utilisez des multiples de 7 jours, au moins 1 à 2 semaines
- Significativité : un repère pour savoir si un écart s'explique difficilement par le hasard. Une p-value n'est pas « la probabilité que B soit gagnante », et « non significatif » ne veut pas dire « il n'y a pas d'écart »
- Éviter les erreurs : ne pas s'arrêter sur des résultats intermédiaires, limiter les changements à ce que couvre une seule hypothèse et utiliser un seul indicateur principal
- Quand le trafic est faible : miser sur les grands changements, les pages à fort trafic et les indicateurs amont, et combler les lacunes par l'observation et les entretiens si cela ne suffit pas
Comme prochaine étape, nous vous recommandons de choisir une page de votre site qui est la plus proche des résultats et qui reçoit beaucoup de visiteurs, et de commencer par vérifier les problèmes de cette page à l'aide de données. Utilisez les heatmaps et l'analyse web pour trouver « où il semble y avoir un problème », puis rédigez une hypothèse qui précise les quatre points : fait, problème, changement et indicateur. Avec une hypothèse en main, vous pouvez estimer les données et la durée nécessaires et concevoir votre premier test A/B.
Un seul test ne changera pas forcément vos chiffres de façon spectaculaire. Mais accumuler des faits vérifiés un par un est le fondement pour améliorer un site sans se fier à son intuition.